0
0
0
Ray 集群运行大模型
2026-10-10
2026-10-10
为什么需要 Ray?
Ai大模型规格太大,单台服务器硬件不满足运行环境
通过ray集群可以实现
- 资源调度
- 任务分发
- 进程管理
- 多机协同执行
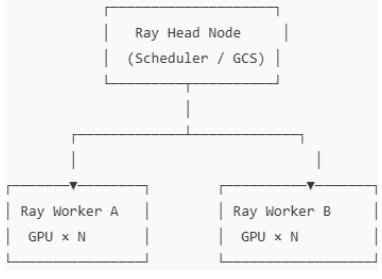
一个 Ray 集群由 Head节点、Worker节点组成:
Head 节点负责:
- 维护集群元数据
- 记录所有 Worker 节点信息
- 统一管理 CPU / GPU / 内存资源
- 提供调度决策(哪个任务去哪台机器跑)
Worker 节点负责:
- 实际执行任务
- 提供 CPU / GPU 资源
- 启动 Ray Worker 进程
- 承载 Actor / Task
集群结构示意
当你在前端问了一个问题,这个请求是如何被 vLLM + Ray + 两台服务器“共同完成”的?
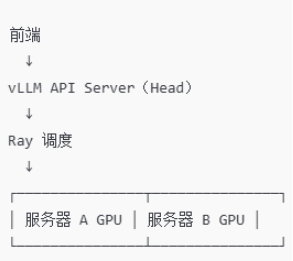
vLLM 不是“任务切分”,而是“模型切分”
集群启动命令
A服务器(head节点) 172.16.1.51
conda activate vllm

export NCCL_SOCKET_IFNAME=ens34
export NCCL_IB_DISABLE=1
export VLLM_DISABLE_CUSTOM_ALL_REDUCE=1

ray start --head \
  --node-ip-address=172.16.1.51 \
  --port=6379 \
  --dashboard-host=0.0.0.0 \
  --dashboard-port=8265
B服务器(Worker节点) 172.16.1.53
conda activate vllm

export NCCL_SOCKET_IFNAME=ens34
export NCCL_IB_DISABLE=1
export VLLM_DISABLE_CUSTOM_ALL_REDUCE=1

ray start \
  --address=172.16.1.51:6379 \
  --node-ip-address=172.16.1.53
启动大模型
在head节点执行
conda activate vllm

export NCCL_SOCKET_IFNAME=ens34
export NCCL_IB_DISABLE=1
export VLLM_DISABLE_CUSTOM_ALL_REDUCE=1
python -m vllm.entrypoints.openai.api_server \
--model /data/models/Qwen2.5-72B-Instruct-AWQ \
  --served-model-name qwen-72b \
--quantization awq \
  --tensor-parallel-size 4 \
  --gpu-memory-utilization 0.85 \
  --max-model-len 32768 \
  --trust-remote-code \
--host 0.0.0.0 \
--port 8000
清理ray进程
conda activate vllm
ray stop --force || true
pkill -f "ray::" || true
pkill -f "raylet|gcs_server|dashboard|runtime_env_agent" || true